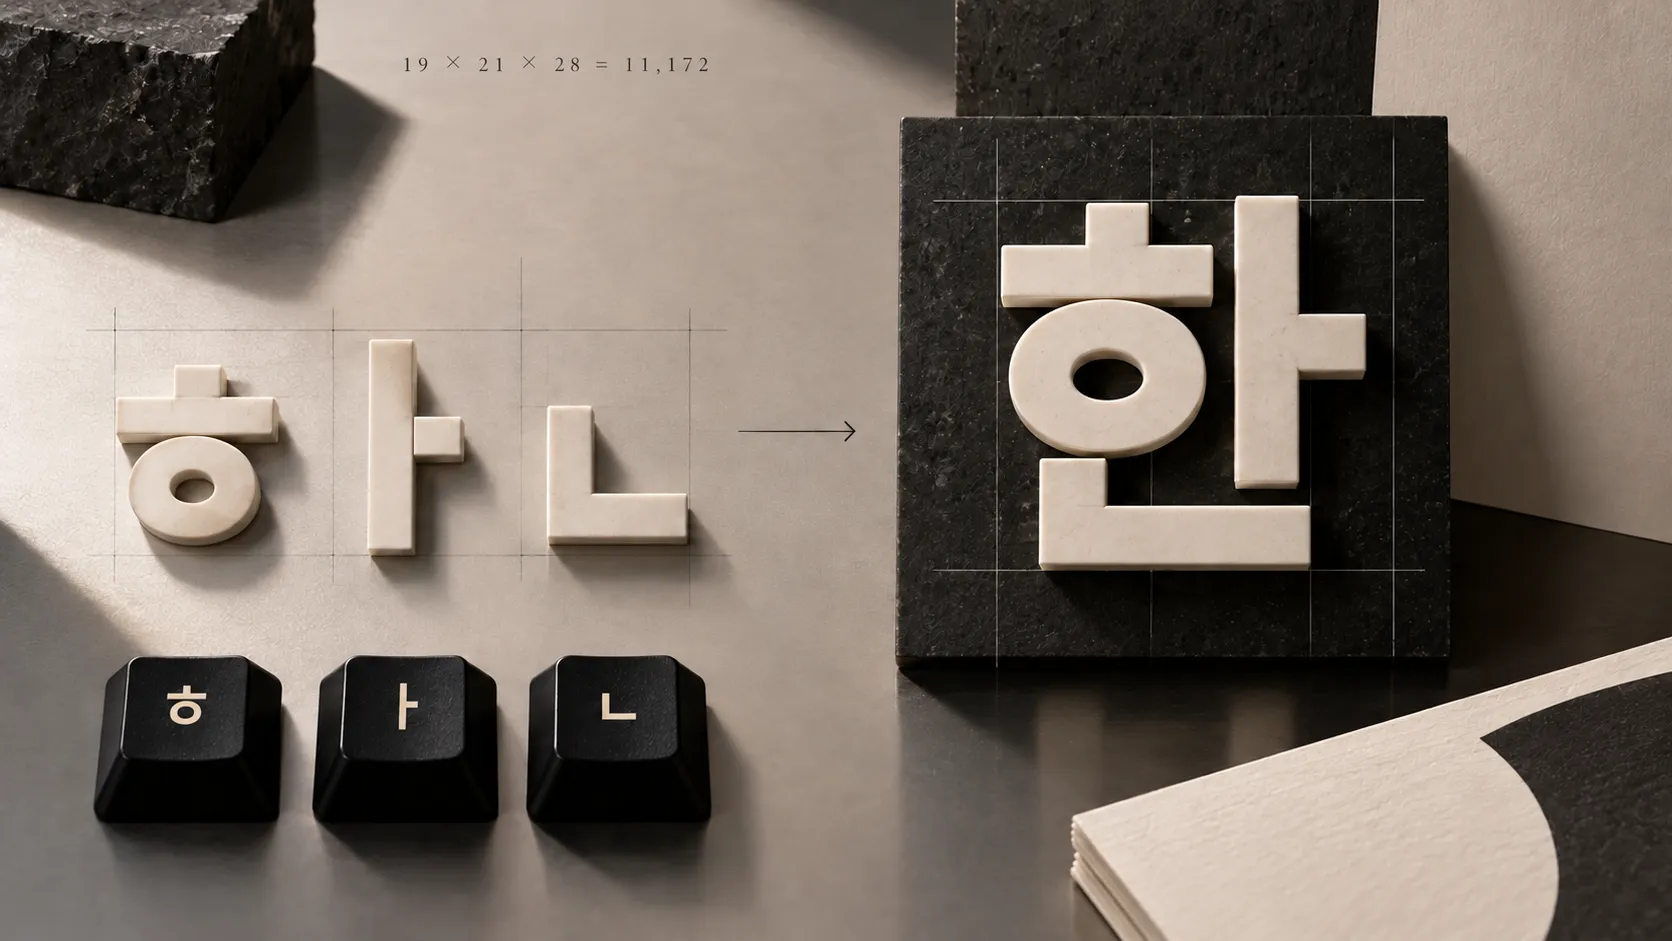
ㅎ·ㅏ·ㄴ을 누르면 ‘한’이 되고, 그 글자는 다시 세 요소로 나뉜다. 소리를 관찰해 만든 글자와 규칙적으로 조합하는 구조가 오늘의 키보드·문자 코드·검색 안에서 어떻게 작동하는지 들여다봤다.
본문
휴대폰에 ‘한’을 입력할 때 손가락은 ㅎ, ㅏ, ㄴ을 차례로 누른다. 화면에는 세 글자가 늘어서는 대신 하나의 음절이 완성된다. 뒤에 ㅏ를 더하면 ‘하나’가 된다. 방금까지 받침이던 ㄴ을 입력기가 다음 음절의 첫소리로 옮긴다.
우리는 그 짧은 변화를 기다리지도 않고 다음 글자를 쓴다. 하지만 기계가 이 일을 하려면 지금 들어온 것이 자음인지 모음인지, 어디에 놓을 수 있는지, 이미 만든 조합을 언제 바꿔야 하는지 알아야 한다. 매일 쓰는 입력창은 한글의 구조를 계속 해석하는 작은 작업 공간이다.
한글의 과학성을 이야기할 때 흥미로운 부분은 ‘과학적’이라는 수식어보다 그 안에서 확인할 수 있는 규칙이다. 소리를 어떻게 나눴고, 관련 소리를 어떤 형태로 묶었으며, 그 재료로 어떻게 음절을 만들었는지 따라가면 문자 설계가 실제로 하는 일이 보인다.
## 소리를 내는 몸에서 글자의 형태를 찾았다
『훈민정음』 제자해는 ㄱ·ㄴ·ㅁ·ㅅ·ㅇ의 기본 모양을 발음기관과 연결해 설명한다. ㄴ은 혀가 윗잇몸에 닿는 모습, ㅁ은 입의 모습에서 형태를 찾았다고 적었다. 눈에 보이지 않는 소리를 적기 위해, 소리를 만드는 몸의 움직임을 관찰한 것이다.
관련 소리를 나타내는 글자에는 획을 더했다. ㄱ과 ㅋ, ㄴ·ㄷ·ㅌ, ㅁ·ㅂ·ㅍ을 나란히 놓으면 글자가 서로 닮은 이유를 찾을 수 있다. 모양을 각각 외우는 데서 끝나지 않고, 소리 사이의 관계도 형태에 남기려 했다.
제자해의 설명을 현대 해부학의 그림과 똑같이 읽을 수는 없고, ㄹ처럼 가획과 다른 원리를 적용한 글자도 있다. 모음의 바탕인 ㆍ·ㅡ·ㅣ에는 하늘·땅·사람이라는 당시의 세계관과 혀의 상태에 대한 설명이 함께 들어 있다. 그 시대의 설명 방식을 살피면서도, 소리를 분석해 글자를 체계로 만든 시도를 구체적으로 읽을 수 있다.
## 글자를 늘리는 대신 조합을 늘린다
‘가’, ‘각’, ‘간’, ‘갈’은 서로 다른 음절이지만 전부 다른 재료로 만드는 것은 아니다. ㄱ과 ㅏ를 두고 받침을 바꾼다. ‘가’와 ‘거’에서는 모음을 바꾼다. 이미 아는 요소를 다른 자리에 넣어 새로운 음절을 만드는 구조다.
현대 한글의 미리 조합된 음절은 초성 19개, 중성 21개, 받침이 없는 경우를 포함한 종성 28개로 계산할 수 있다. 19 × 21 × 28 = 11,172. 유니코드에 들어 있는 현대 한글 음절 수가 이 값이다. 실제 단어에서 잘 쓰지 않는 조합도 포함하며, 옛한글의 모든 표현을 이 숫자에 넣은 것은 아니다.
키보드에 11,172개의 음절 키가 필요하지 않은 이유도 여기에 있다. 자판은 자모를 받고 입력기가 조합을 만든다. 어떤 순서로 자모를 받아들이고 조합을 고칠지는 입력기가 구현할 일이지만, 그 구현이 기대는 문자 구조는 일관되게 나눠 볼 수 있다.
## 컴퓨터도 ‘한’을 다시 풀 수 있다
유니코드는 현대 한글 음절을 무작위 순서로 늘어놓지 않았다. 초성·중성·종성의 순서에 따라 배치해 산술적으로 조합하거나 분해할 수 있게 했다. 화면에서는 하나인 글자가 데이터에서는 규칙을 가진 값이 된다.
예를 들어 0부터 세면 ‘한’의 초성 ㅎ은 18번, 중성 ㅏ는 0번, 종성 ㄴ은 4번이다. 받침이 없는 경우가 종성 0번이다. ‘가’의 코드값에 (18 × 21 + 0) × 28 + 4를 더하면 ‘한’의 코드값을 얻는다. 반대로 계산하면 그 음절에서 ㅎ·ㅏ·ㄴ의 자리를 알아낼 수 있다.
초성 검색은 이 구조를 활용할 수 있는 익숙한 사례다. ‘한글’에서 첫소리 ㅎ과 ㄱ을 꺼내 ‘ㅎㄱ’과 비교한다. 단어의 뜻을 모두 이해하지 않아도 글자의 구성 요소를 다루는 것만으로 가능한 검색이다. 다만 초성 검색 자체는 유니코드가 자동으로 해 주는 기능이 아니라, 프로그램이 그 구조를 이용해 구현하는 기능이다.
## 같은 글자도 데이터에서는 다를 수 있다
‘한’을 하나의 완성된 음절 코드로 저장할 수도 있고, 결합용 초성·중성·종성 코드의 연속으로 저장할 수도 있다. 화면의 결과가 같아도 컴퓨터 안의 표현은 달라질 수 있다. 그래서 프로그램은 글자를 비교하거나 검색할 때 표현을 맞추는 정규화를 고려한다.
여기서 키보드의 ㄱ·ㄴ 같은 독립 자모와 음절을 구성하는 결합용 자모는 구분된다. 보이는 형태가 닮았다고 아무 코드나 이어 붙이면 같은 음절이 되는 것은 아니다. 사람에게 자연스러운 모아쓰기를 기계에서도 자연스럽게 다루려면 문자 표준과 입력기, 글꼴이 함께 맞물려야 한다.
한글의 설계가 특히 흥미로운 지점은 소리의 분석과 글자의 조합을 연결해 두었다는 데 있다. 세종이 컴퓨터를 예상해서 만든 것은 아니지만, 오늘의 기술은 그 구조를 입력과 계산에 활용한다. ㅎ·ㅏ·ㄴ을 누르는 짧은 순간에 소리를 적는 원리, 음절을 만드는 규칙, 글자를 처리하는 소프트웨어가 함께 작동한다.
확인 자료
국사편찬위원회 우리역사넷 · 『훈민정음』 제자해 원문·번역과 구성 원리
https://contents.history.go.kr/front/hm/view.do?levelId=hm_091_0030
국립한글박물관 · 훈민정음 표준 해설서
https://www.hangeul.go.kr/published-data/academicArchives/598
Unicode Consortium · Korean FAQ, 현대 한글 음절과 자모 조합
https://www.unicode.org/faq/korean.html
국립국어원 · 한글 맞춤법 총칙과 해설
https://www.korean.go.kr/kornorms/m/m_regltn.do
국립국어원 · 새국어소식, ‘어법에 맞도록’의 의미
https://www.korean.go.kr/nkview/nknews/200111/40_5.html
Unicode Standard · 한글 음절의 산술 분해·조합 알고리즘
https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-3/
우리는 그 짧은 변화를 기다리지도 않고 다음 글자를 쓴다. 하지만 기계가 이 일을 하려면 지금 들어온 것이 자음인지 모음인지, 어디에 놓을 수 있는지, 이미 만든 조합을 언제 바꿔야 하는지 알아야 한다. 매일 쓰는 입력창은 한글의 구조를 계속 해석하는 작은 작업 공간이다.
한글의 과학성을 이야기할 때 흥미로운 부분은 ‘과학적’이라는 수식어보다 그 안에서 확인할 수 있는 규칙이다. 소리를 어떻게 나눴고, 관련 소리를 어떤 형태로 묶었으며, 그 재료로 어떻게 음절을 만들었는지 따라가면 문자 설계가 실제로 하는 일이 보인다.
## 소리를 내는 몸에서 글자의 형태를 찾았다
『훈민정음』 제자해는 ㄱ·ㄴ·ㅁ·ㅅ·ㅇ의 기본 모양을 발음기관과 연결해 설명한다. ㄴ은 혀가 윗잇몸에 닿는 모습, ㅁ은 입의 모습에서 형태를 찾았다고 적었다. 눈에 보이지 않는 소리를 적기 위해, 소리를 만드는 몸의 움직임을 관찰한 것이다.
관련 소리를 나타내는 글자에는 획을 더했다. ㄱ과 ㅋ, ㄴ·ㄷ·ㅌ, ㅁ·ㅂ·ㅍ을 나란히 놓으면 글자가 서로 닮은 이유를 찾을 수 있다. 모양을 각각 외우는 데서 끝나지 않고, 소리 사이의 관계도 형태에 남기려 했다.
제자해의 설명을 현대 해부학의 그림과 똑같이 읽을 수는 없고, ㄹ처럼 가획과 다른 원리를 적용한 글자도 있다. 모음의 바탕인 ㆍ·ㅡ·ㅣ에는 하늘·땅·사람이라는 당시의 세계관과 혀의 상태에 대한 설명이 함께 들어 있다. 그 시대의 설명 방식을 살피면서도, 소리를 분석해 글자를 체계로 만든 시도를 구체적으로 읽을 수 있다.
## 글자를 늘리는 대신 조합을 늘린다
‘가’, ‘각’, ‘간’, ‘갈’은 서로 다른 음절이지만 전부 다른 재료로 만드는 것은 아니다. ㄱ과 ㅏ를 두고 받침을 바꾼다. ‘가’와 ‘거’에서는 모음을 바꾼다. 이미 아는 요소를 다른 자리에 넣어 새로운 음절을 만드는 구조다.
현대 한글의 미리 조합된 음절은 초성 19개, 중성 21개, 받침이 없는 경우를 포함한 종성 28개로 계산할 수 있다. 19 × 21 × 28 = 11,172. 유니코드에 들어 있는 현대 한글 음절 수가 이 값이다. 실제 단어에서 잘 쓰지 않는 조합도 포함하며, 옛한글의 모든 표현을 이 숫자에 넣은 것은 아니다.
키보드에 11,172개의 음절 키가 필요하지 않은 이유도 여기에 있다. 자판은 자모를 받고 입력기가 조합을 만든다. 어떤 순서로 자모를 받아들이고 조합을 고칠지는 입력기가 구현할 일이지만, 그 구현이 기대는 문자 구조는 일관되게 나눠 볼 수 있다.
## 컴퓨터도 ‘한’을 다시 풀 수 있다
유니코드는 현대 한글 음절을 무작위 순서로 늘어놓지 않았다. 초성·중성·종성의 순서에 따라 배치해 산술적으로 조합하거나 분해할 수 있게 했다. 화면에서는 하나인 글자가 데이터에서는 규칙을 가진 값이 된다.
예를 들어 0부터 세면 ‘한’의 초성 ㅎ은 18번, 중성 ㅏ는 0번, 종성 ㄴ은 4번이다. 받침이 없는 경우가 종성 0번이다. ‘가’의 코드값에 (18 × 21 + 0) × 28 + 4를 더하면 ‘한’의 코드값을 얻는다. 반대로 계산하면 그 음절에서 ㅎ·ㅏ·ㄴ의 자리를 알아낼 수 있다.
초성 검색은 이 구조를 활용할 수 있는 익숙한 사례다. ‘한글’에서 첫소리 ㅎ과 ㄱ을 꺼내 ‘ㅎㄱ’과 비교한다. 단어의 뜻을 모두 이해하지 않아도 글자의 구성 요소를 다루는 것만으로 가능한 검색이다. 다만 초성 검색 자체는 유니코드가 자동으로 해 주는 기능이 아니라, 프로그램이 그 구조를 이용해 구현하는 기능이다.
## 같은 글자도 데이터에서는 다를 수 있다
‘한’을 하나의 완성된 음절 코드로 저장할 수도 있고, 결합용 초성·중성·종성 코드의 연속으로 저장할 수도 있다. 화면의 결과가 같아도 컴퓨터 안의 표현은 달라질 수 있다. 그래서 프로그램은 글자를 비교하거나 검색할 때 표현을 맞추는 정규화를 고려한다.
여기서 키보드의 ㄱ·ㄴ 같은 독립 자모와 음절을 구성하는 결합용 자모는 구분된다. 보이는 형태가 닮았다고 아무 코드나 이어 붙이면 같은 음절이 되는 것은 아니다. 사람에게 자연스러운 모아쓰기를 기계에서도 자연스럽게 다루려면 문자 표준과 입력기, 글꼴이 함께 맞물려야 한다.
한글의 설계가 특히 흥미로운 지점은 소리의 분석과 글자의 조합을 연결해 두었다는 데 있다. 세종이 컴퓨터를 예상해서 만든 것은 아니지만, 오늘의 기술은 그 구조를 입력과 계산에 활용한다. ㅎ·ㅏ·ㄴ을 누르는 짧은 순간에 소리를 적는 원리, 음절을 만드는 규칙, 글자를 처리하는 소프트웨어가 함께 작동한다.
확인 자료
국사편찬위원회 우리역사넷 · 『훈민정음』 제자해 원문·번역과 구성 원리
https://contents.history.go.kr/front/hm/view.do?levelId=hm_091_0030
국립한글박물관 · 훈민정음 표준 해설서
https://www.hangeul.go.kr/published-data/academicArchives/598
Unicode Consortium · Korean FAQ, 현대 한글 음절과 자모 조합
https://www.unicode.org/faq/korean.html
국립국어원 · 한글 맞춤법 총칙과 해설
https://www.korean.go.kr/kornorms/m/m_regltn.do
국립국어원 · 새국어소식, ‘어법에 맞도록’의 의미
https://www.korean.go.kr/nkview/nknews/200111/40_5.html
Unicode Standard · 한글 음절의 산술 분해·조합 알고리즘
https://www.unicode.org/versions/Unicode17.0.0/core-spec/chapter-3/
편집 안내
본문의 출처 링크는 새 창으로 열립니다.